GPT-6 Sol·Luna vs Claude Opus 5.5 — 같은 날 나온 두 신형 모델, 실제로 뭐가 다를까
2026년 9월 22일 같은 날 공개된 GPT-6 Sol·Luna와 Claude Opus 5.5를 비교했습니다. 공식 가격표와 컨텍스트, 독립 벤치마크 점수, 실제 토큰 비용 계산, 개발자 커뮤니티 후기까지 한 번에 정리했습니다.
2026년 9월 22일, 하루 사이에 두 회사의 신형 모델이 나란히 공개됐습니다. Anthropic이 Claude Opus 5.5를 발표했고, 그로부터 한 시간쯤 뒤 OpenAI가 GPT-6 Sol과 GPT-6 Luna를 내놨습니다 (Simon Willison 정리).
두 회사 모두 "더 싸졌다"를 앞세웠는데, 정작 어떤 작업에 어느 쪽이 맞는지는 발표문만 봐서는 잘 안 보입니다. 그래서 이 글에서는 공식 문서의 숫자를 먼저 정리하고, 같은 조건에서 측정된 독립 평가를 따로 붙였습니다. 마지막에는 개발자 커뮤니티에서 실제로 어떤 이야기가 나왔는지도 담았습니다.
한 가지 미리 말씀드릴 게 있습니다. 세 모델은 서로 다른 회사의 벤치마크 기준을 쓰기 때문에, 발표문 숫자를 그대로 나란히 놓고 비교하면 안 됩니다. 이 글에서는 어디까지가 제조사 발표이고 어디부터가 독립 측정인지 계속 구분해서 표시합니다.
1. 세 모델은 어떤 모델인가
GPT-6 Sol은 OpenAI의 GPT-6 계열에서 "고성능이지만 합리적인 가격" 자리를 맡습니다. 최상위 플래그십은 GPT-6 Astra이고, Sol은 그 아래에서 복잡한 코딩과 에이전트 작업을 담당합니다. 공식 문서 표현은 "복잡한 코딩·에이전트 워크플로우에 맞춰 설계"입니다 (OpenAI 모델 문서).
GPT-6 Luna는 같은 계열의 가장 저렴한 모델입니다. OpenAI는 Luna를 "명확한 목표가 있는 대량 작업", 예를 들어 문서 요약이나 정보 추출, 짧은 질문 응답에 적합하다고 설명합니다 (TechCrunch). 다만 추론 강도를 높이면 예전에는 Sol급이 필요했던 소프트웨어 엔지니어링·컴퓨터 사용 작업도 감당한다고 밝혔습니다.
Claude Opus 5.5는 Anthropic의 새 5.5 세대 첫 모델로, "장시간 실행되는 에이전트 코딩과 지식 노동"을 겨냥합니다 (Anthropic 발표). 회사는 Opus 5.5가 자사의 상위 모델인 Fable 5.1과 비슷한 수준이면서 Opus 5보다 40% 저렴하게 돌아간다고 주장합니다.
참고로 GPT-5.6 세대에 있던 Terra 이름은 GPT-6 세대에서 사라졌습니다. Astra·Sol·Luna 세 개로 정리된 셈입니다.
2. 한눈에 보는 스펙 및 가격 비교
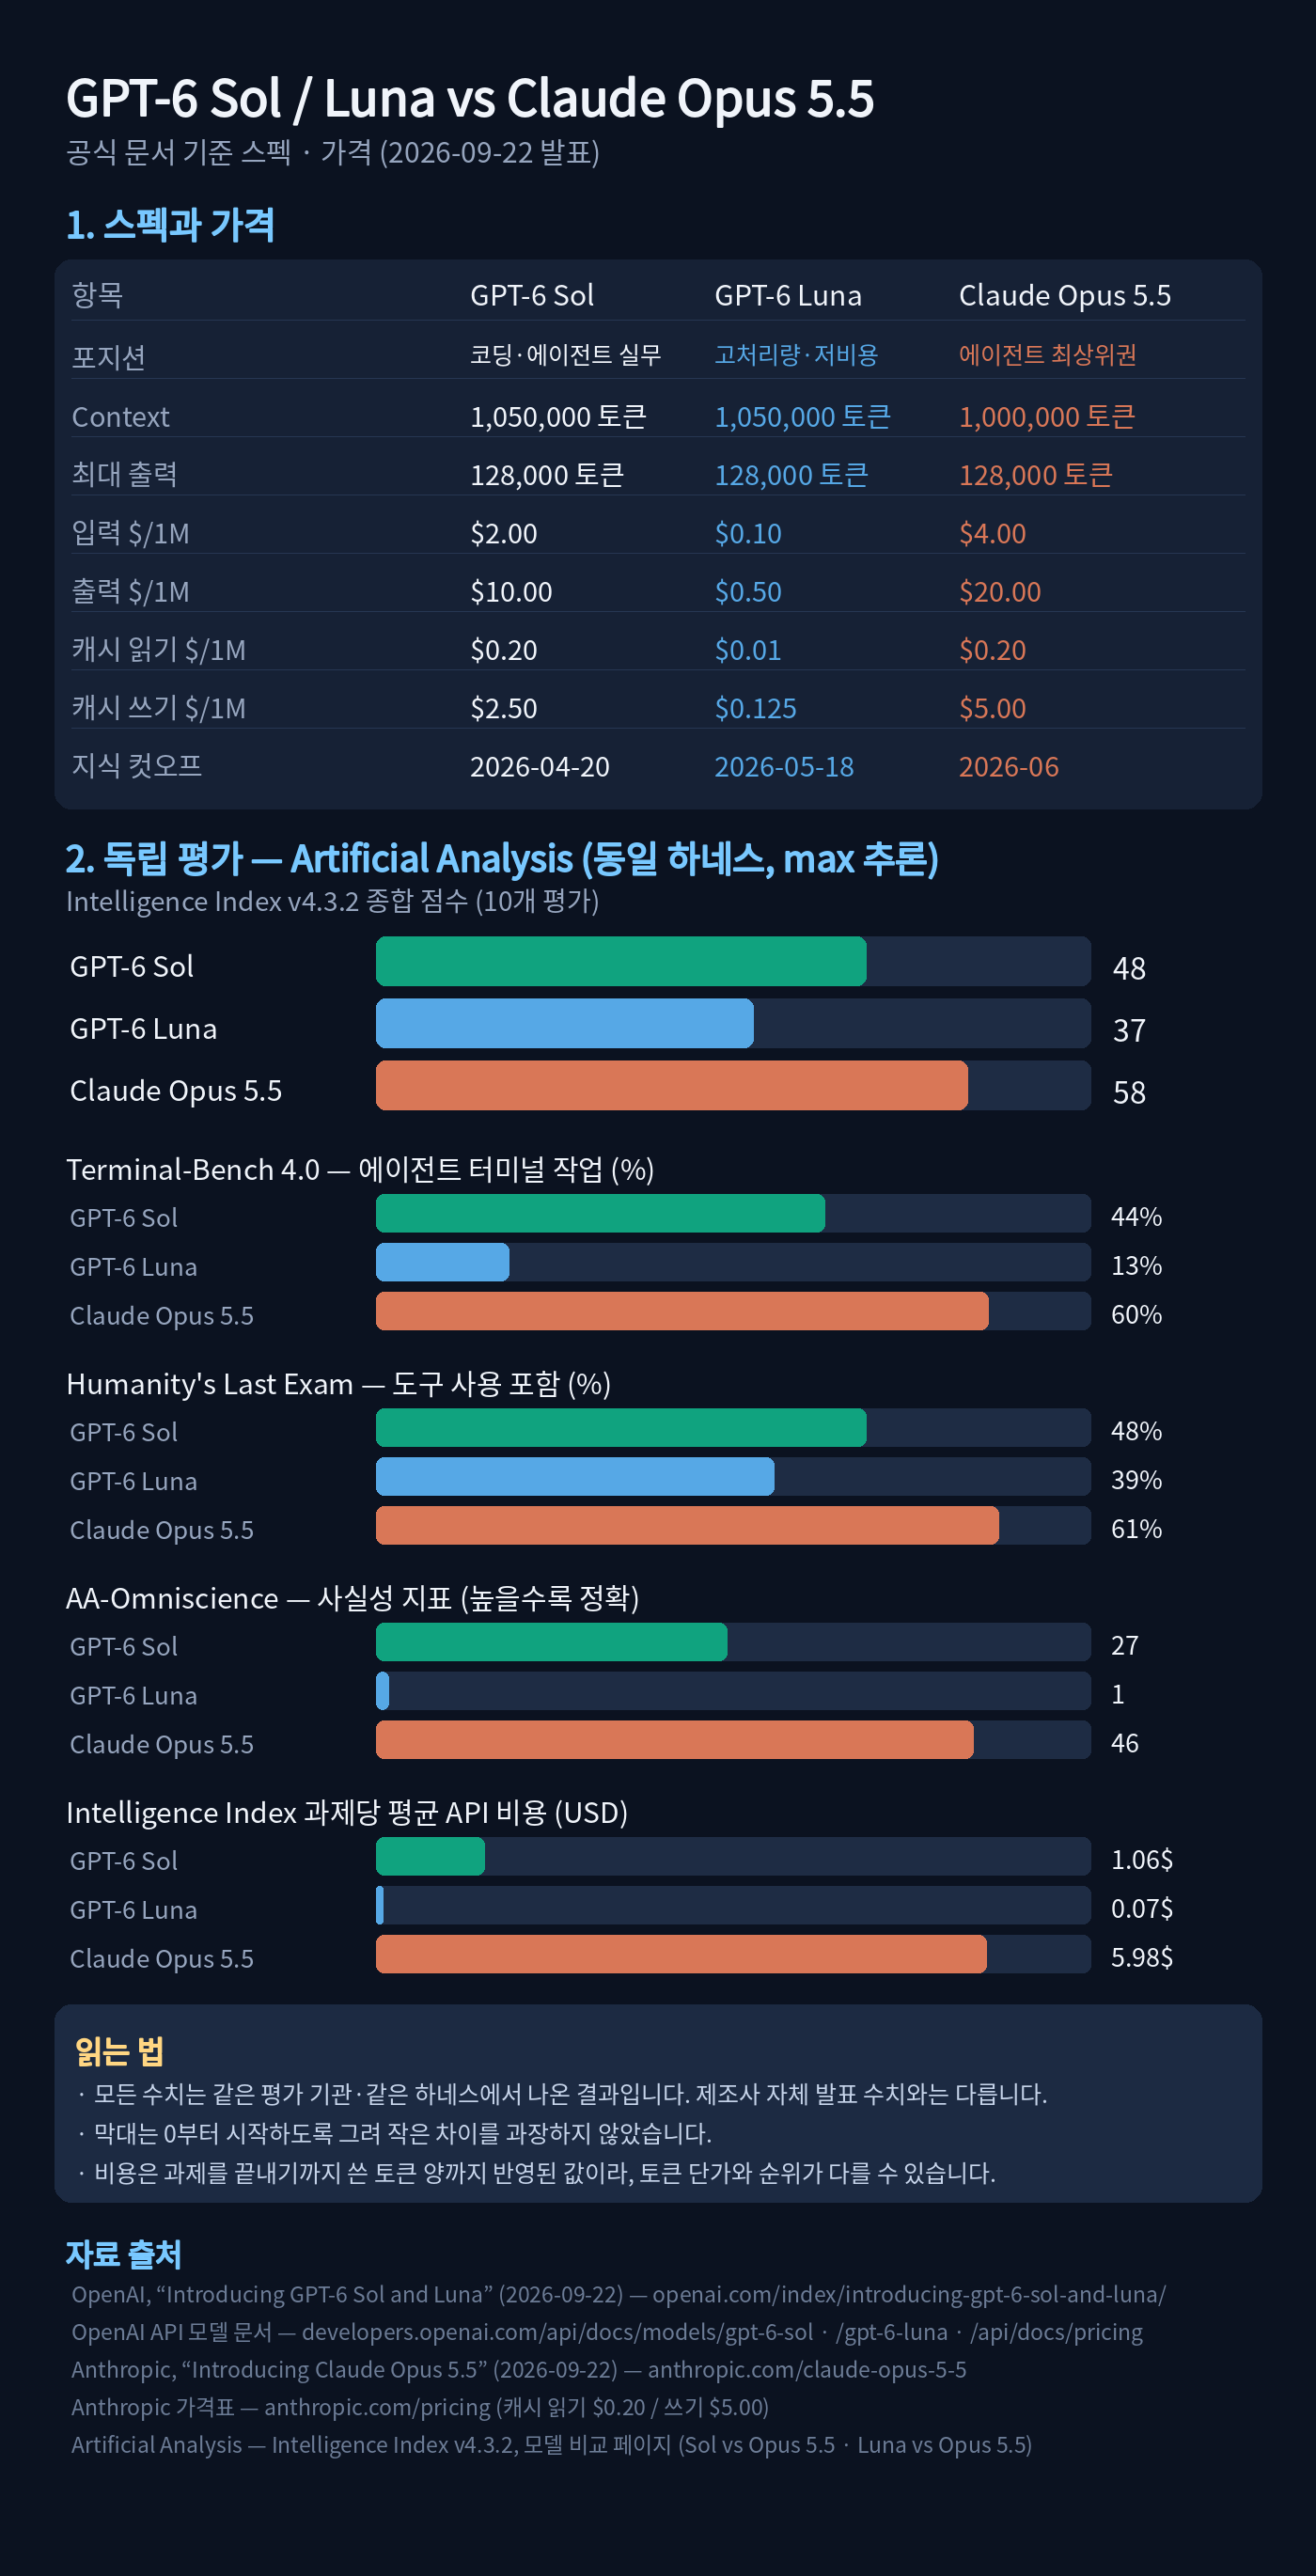
가격은 모두 100만 토큰당 미국 달러이고, OpenAI는 입력 272,000토큰 이하(단거리) 기준입니다. 이 기준을 넘으면 요청 전체가 더 비싼 장거리 요율로 청구됩니다.
| 항목 | GPT-6 Sol | GPT-6 Luna | Claude Opus 5.5 |
|---|---|---|---|
| 포지션 | 실무 코딩·에이전트 | 고처리량·저비용 | 에이전트 코딩 최상위 |
| 입력 $/1M | $2.00 | $0.10 | $4.00 |
| 출력 $/1M | $10.00 | $0.50 | $20.00 |
| 캐시 읽기 $/1M | $0.20 | $0.01 | $0.20 |
| 캐시 쓰기 $/1M | $2.50 | $0.125 | $5.00 |
| Context | 1,050,000 | 1,050,000 | 1,000,000 |
| 최대 출력 | 128,000 | 128,000 | 128,000 |
| 지식 컷오프 | 2026-04-20 | 2026-05-18 | 2026-06 |
| 코딩 (AA Index) | 48 | 37 | 58 |
| 추론 (HLE, 도구 포함) | 48% | 39% | 61% |
| 에이전트 (Terminal-Bench 4.0) | 44% | 13% | 60% |
| 속도 (출력 토큰/초) | 89 | 167 | 95 |
| 과제당 평균 비용 (AA) | $1.06 | $0.07 | $5.98 |
출처: OpenAI Sol 문서 · OpenAI Luna 문서 · OpenAI 가격표 · Anthropic 가격표 · Claude Opus 5.5 문서 · Artificial Analysis 동일 하네스 비교(Sol vs Opus 5.5, Luna vs Opus 5.5)
먼저 짚을 점 두 가지입니다.
컨텍스트 윈도우는 "AI가 한 번에 기억하면서 처리할 수 있는 정보의 양"입니다. 숫자만 보면 Sol·Luna가 105만 토큰으로 Opus 5.5의 100만 토큰보다 조금 큽니다. 그런데 독립 평가 기관 Artificial Analysis의 모델 페이지에는 Sol이 872,000토큰으로 적혀 있어 제조사 문서와 차이가 납니다. 그래서 표에는 공식 문서 수치를 적고, 이런 출처 간 불일치가 있다는 사실을 따로 남겨둡니다.
가격은 Luna가 압도적으로 쌉니다. 입력 기준 Sol의 20분의 1, Opus 5.5의 40분의 1입니다. 다만 단가가 싸다는 것과 한 작업을 끝내는 데 드는 돈이 싸다는 것은 다른 이야기이고, 이 차이는 뒤에서 다시 다룹니다.
3. 벤치마크 비교 — 제조사 발표와 독립 측정을 나눠서
벤치마크 이름이 같아도 하네스(모델을 돌리는 실행 환경), 추론 강도, 채점 방식이 다르면 점수는 달라집니다. 그래서 여기서는 (1) 제조사가 자기 모델을 평가한 숫자, (2) 제3자가 같은 조건에서 돌린 숫자를 분리합니다.
3-1. Anthropic이 발표한 숫자
| 평가 | Claude Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| GDPval-AA v2.1 | 1,846 | 1,735 | 1,708 | 1,542 | 1,588 |
| Humanity's Last Exam (도구) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| OSWorld 2.0 (컴퓨터 사용) | 81.8% | 80.7% | 74.0% | — | — |
Anthropic은 여기에 조건을 세세히 달아뒀습니다. Opus 5.5 결과는 대체로 max 추론, Terminal-Bench만 xhigh이고, GPT-6 Astra 수치는 OpenAI가 발표한 값을 그대로 인용한 것입니다. 또 안전장치가 개입하면 사이버보안 작업은 Opus 4.8이, 생물·프런티어 개발 작업은 Opus 5가 대신 처리했기 때문에 점수가 실제보다 낮게 나왔을 수 있다고 밝혔습니다 (Anthropic 발표).
3-2. OpenAI가 발표한 숫자
OpenAI가 내세운 건 자사 내부 사실성 평가입니다. 사용자가 오류를 신고한 실제 대화를 바탕으로 한 평가에서 GPT-6 Sol이 이전 모델보다 오류를 절반가량 줄였다는 주장입니다 (OpenAI 발표).
에이전트 작업 쪽에서는 AutomationBench(여러 앱을 넘나드는 업무 흐름 테스트)에서 GPT-6 Sol(xhigh)이 33.2%, 과제당 $0.27을 기록해 Claude Opus 5(max) 26.9%보다 높은 점수를 약 11분의 1 비용으로 냈다고 밝혔습니다. 코딩 벤치마크 DeepSWE 1.1에서는 Sol 68.8%, Luna 66.6%입니다.
두 회사 주장을 그대로 겹쳐놓으면 어느 쪽이 이겼는지 판단할 수 없습니다. 실제로 두 발표에서 공통으로 등장하는 벤치마크는 FrontierCode와 AutomationBench 정도뿐입니다. 커뮤니티에서도 이 점이 지적됐는데, Hacker News의 한 개발자는 "Sol은 AutomationBench에서 같은 성능을 절반 비용에 내고, Opus 5.5는 FrontierCode에서 2~5% 앞선다"고 정리했습니다.
3-3. 독립 측정 — Artificial Analysis
같은 기관이 같은 하네스로 세 모델을 모두 돌린 결과입니다. 추론 강도는 모두 max입니다.
| 평가 | GPT-6 Sol | GPT-6 Luna | Claude Opus 5.5 |
|---|---|---|---|
| Intelligence Index (종합) | 48 | 37 | 58 |
| Terminal-Bench 4.0 | 44% | 13% | 60% |
| SciCode | 58% | 55% | 67% |
| Humanity's Last Exam | 48% | 39% | 61% |
| GDP.pdf | 25% | 20% | 26% |
| CritPt | 31% | 19% | 32% |
| AA-Omniscience (사실성) | 27 | 1 | 46 |
| AA-LCR v1.1 (장문 이해) | 84% | 83% | 85% |
| 과제당 평균 비용 | $1.06 | $0.07 | $5.98 |
| 과제당 출력 토큰 | 31,000 | 51,000 | 119,000 |
| 출력 속도 | 89 t/s | 167 t/s | 95 t/s |
| 과제당 소요 시간 | 351초 | 303초 | 798초 |
여기서 눈에 띄는 건 두 가지입니다.
첫째, Claude Opus 5.5는 "느리다"기보다 "오래 생각한다"에 가깝습니다. 출력 속도 자체는 95 t/s로 Sol(89)보다 조금 빠른데, 과제당 출력 토큰을 119,000개나 씁니다. Sol은 31,000개입니다. 그래서 첫 응답이 나오기까지 걸리는 시간은 Opus 5.5가 682초, Sol이 138초로 크게 벌어집니다.
둘째, 같은 코딩 에이전트 지수(Coding Agent Index v1.5)에서도 순위와 비용이 엇갈립니다. Opus 5.5는 Claude Code 환경 max 추론에서 66점(과제당 $13.04), GPT-6 Sol은 Codex 환경에서 57점(과제당 $2.99)을 기록했습니다. Anthropic이 토큰 단가를 20% 내렸는데도 Opus 5.5의 과제당 비용은 Opus 5($10.79)보다 오히려 올랐습니다. 토큰을 훨씬 많이 쓰기 때문입니다 (Artificial Analysis 분석, Digg 정리).
주의할 점도 있습니다. Terminal-Bench 4.0에서 Anthropic 자체 측정은 66.4%인데, Artificial Analysis가 자기 하네스로 돌린 값은 59.6%입니다. 발표 당일 공개 리더보드에는 Opus 5.5 결과 자체가 없었습니다 (mixed-news). 같은 벤치마크 이름으로 66.4%, 63.1%, 59.6% 세 숫자가 존재하는 셈이라, 하나만 인용하면 오해를 만들 수 있습니다.
4. 토큰 가격 비교 — 실제 사용 비용 계산
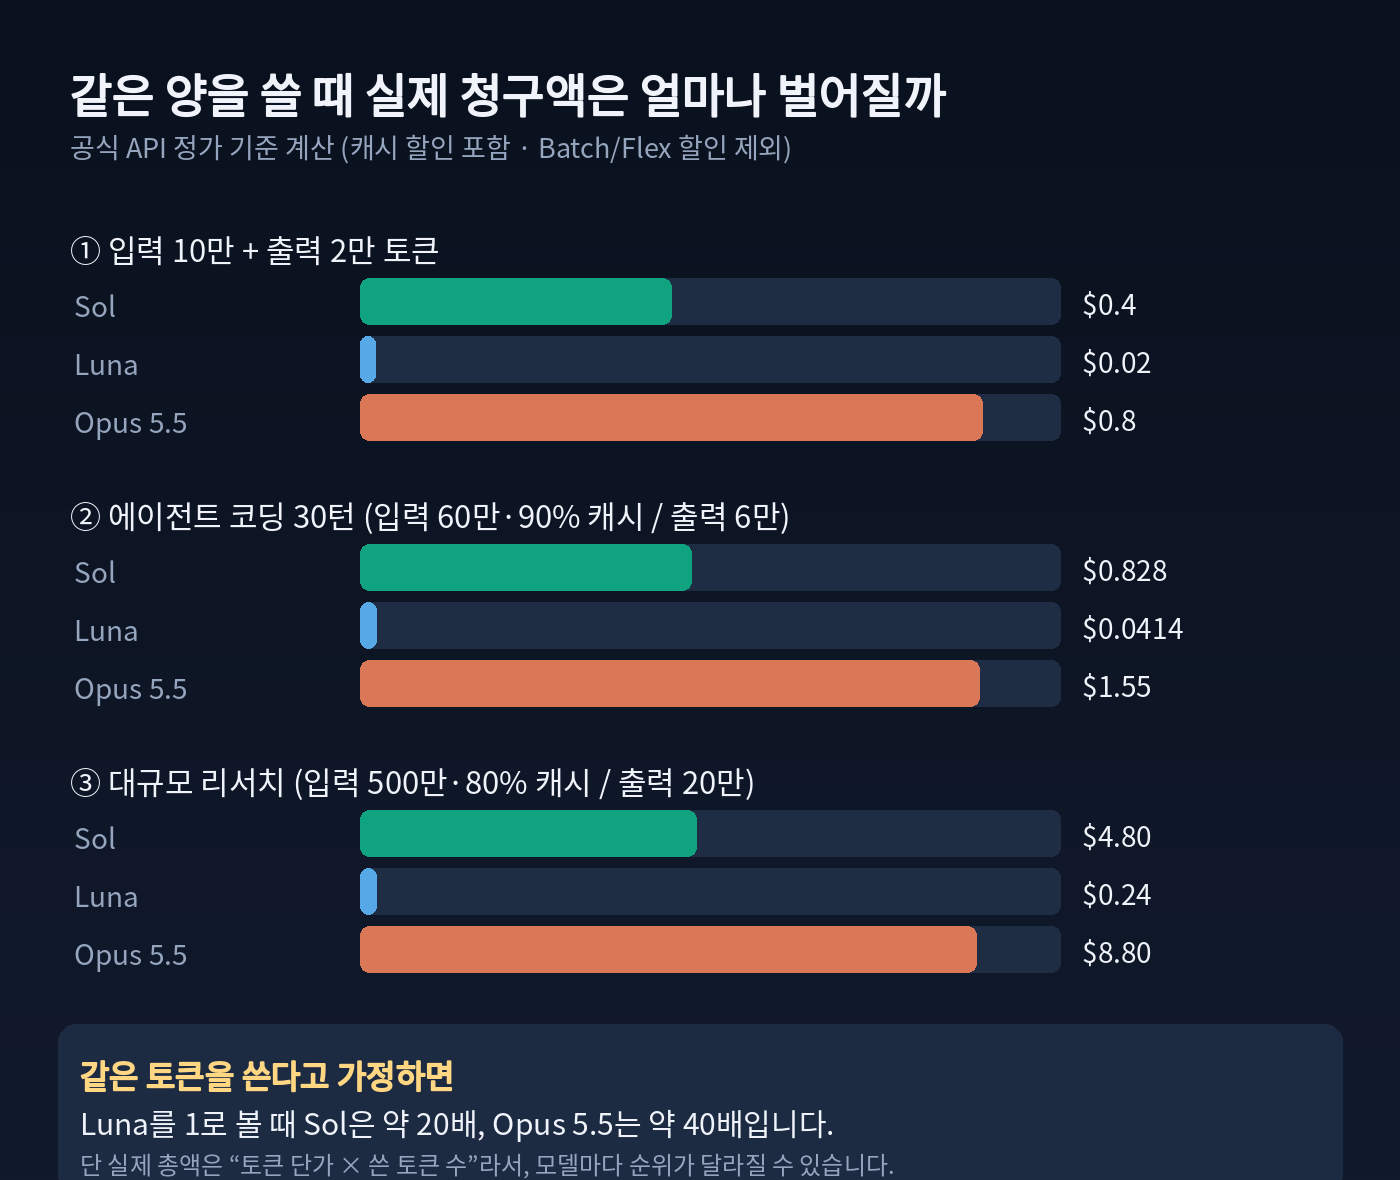
단가표만 보면 감이 안 오니, 흔한 사용 패턴 세 가지로 계산해보겠습니다. 계산식은 신규 입력 × 입력단가 + 캐시 재사용 입력 × 캐시읽기단가 + 출력 × 출력단가이고, Batch·Flex 할인은 제외했습니다. 즉 가장 보수적인(비싸게 나오는) 값입니다.
전제 조건
- 캐시 할인: 캐시에 남아 있는 앞부분을 다시 읽을 때 적용되는 할인입니다. 긴 대화나 반복되는 시스템 프롬프트에서 실제 청구액을 크게 줄여줍니다.
- OpenAI 단거리 기준(입력 272,000토큰 이하)을 넘지 않는다고 가정했습니다.
① 가벼운 질문 한 번 — 입력 10만 + 출력 2만 토큰
| 모델 | 계산 | 비용 |
|---|---|---|
| GPT-6 Sol | (0.1 × $2) + (0.02 × $10) | $0.40 |
| GPT-6 Luna | (0.1 × $0.10) + (0.02 × $0.50) | $0.02 |
| Claude Opus 5.5 | (0.1 × $4) + (0.02 × $20) | $0.80 |
② 에이전트 코딩 세션 30턴 — 총 입력 60만(그중 90% 캐시 재사용) + 출력 6만
| 모델 | 계산 | 비용 |
|---|---|---|
| GPT-6 Sol | (0.06 × $2) + (0.54 × $0.20) + (0.06 × $10) | $0.83 |
| GPT-6 Luna | (0.06 × $0.10) + (0.54 × $0.01) + (0.06 × $0.50) | $0.04 |
| Claude Opus 5.5 | (0.06 × $4) + (0.54 × $0.20) + (0.06 × $20) | $1.55 |
③ 대규모 리서치 — 총 입력 500만(80% 캐시 재사용) + 출력 20만
| 모델 | 계산 | 비용 |
|---|---|---|
| GPT-6 Sol | (1 × $2) + (4 × $0.20) + (0.2 × $10) | $4.80 |
| GPT-6 Luna | (1 × $0.10) + (4 × $0.01) + (0.2 × $0.50) | $0.24 |
| Claude Opus 5.5 | (1 × $4) + (4 × $0.20) + (0.2 × $20) | $8.80 |
같은 토큰을 쓴다고 가정하면 Luna를 1로 볼 때 Sol은 약 20배, Opus 5.5는 약 40배입니다.
그런데 여기에 반드시 붙여야 할 단서가 있습니다. 실제 청구액은 "단가 × 쓴 토큰 수"입니다. Artificial Analysis 측정에서 Opus 5.5는 같은 과제를 끝내는 데 Sol의 약 4배에 가까운 출력 토큰을 썼습니다. 반대로 Luna는 단가가 싼 만큼 토큰을 더 쓰는 경향이 있어서, 단가만큼의 배수 차이가 나지 않을 수 있습니다. 단가는 출발점이고, 최종 판단은 "작업 하나를 끝내는 데 든 돈"으로 해야 합니다.
5. 실제 사용 후기 — Hacker News / Reddit / X
공식 문서만으로는 안 보이는 부분이라, 커뮤니티 반응을 따로 모았습니다. 개인 경험담은 개인 경험담으로만 다뤘습니다.
GPT-6 Sol에 대한 반응은 갈렸습니다.
- Hacker News에서 GPT-6 Sol/Luna 발표 스레드(댓글 700여 개)는 비용 이야기와 "체감 품질" 이야기가 반씩 섞였습니다. 한 사용자(bradly)는 "5.6 Sol보다 나빴을 뿐 아니라 Plus 사용량이 몇 분 만에 사라졌다"고 썼고, 다른 사용자(jdw64)는 "지시를 잘 따르고 좋은 코드를 썼다"고 평가했습니다.
- 사용량 한도가 오히려 더 빠르게 닳는다는 불만도 반복됐습니다. joshstrange는 "Codex 쪽이 사용량이 훨씬 빨리 소진되고 컨텍스트도 답답하다"고 적었습니다.
- Reddit r/codex의 "Sol 6 is a slop fest" 스레드에서는 지시 범위를 넘어서는 과잉 구현이 도마에 올랐습니다. 요청하지 않은 백업 로직과 다른 프로젝트 수정까지 했다는 사례, AGENTS.md 규칙을 어겼다는 사례가 이어졌고, "Luna 6.0이 오히려 낫다", "Opus 5.5로 돌아가겠다"는 댓글이 붙었습니다.
- 반대로 "과잉 검증이 줄어서 좋다"는 평가도 있었습니다. Hacker News의 darklinear는 "Sol은 불가능한 상황까지 try/except로 감싸는 경향이 있어서, 작은 단위로 쪼개 읽으면서 쓰기에는 Terra의 코드가 더 좋았다"고 썼습니다.
GPT-6 Luna에 대해서는 가격 대비 성능에 대한 감탄이 많았습니다.
- Hacker News의 gizmodo59는 "Luna는 대부분 과제에서 파레토 최전선에 있다. 폐쇄 모델인데 이 정도 가치면 이해가 안 될 정도"라고 썼습니다.
- 같은 스레드의 Alifatisk는 "Luna(max)가 정말 저렴한데 똑똑하다. Luna medium으로도 훌륭한 결과를 만드는 동료들을 봤다"고 적었습니다.
- 다만 "Luna가 DeepSWE에서 이전 버전보다 2점 낮아졌다"는 Artificial Analysis 지적을 인용하며, 저렴해진 대신 일부 지표는 후퇴했다는 점을 짚은 사용자도 있었습니다.
- 실전 조합을 공유한 사례도 있습니다. rbranson은 "Astra를 설계자로, Luna가 코드 생성, Sol이 리뷰와 통합 테스트를 맡기니 사용량 효율이 20% 좋아지고 작업 완료도 20% 빨라졌다"고 밝혔습니다.
Claude Opus 5.5는 "말이 통한다"는 평가가 많았습니다.
- Anthropic이 이번 발표에서 직접 언급한 것처럼, 직전 Opus 5의 가장 큰 불만은 장황한 말투였습니다. Opus 5.5는 이 문제를 정면으로 겨냥했습니다. 문체 개선을 다룬 한 분석 글은 "7월의 반응과 정반대로, 벤치마크가 예뻐져서가 아니라 두 번 읽지 않고도 의도가 파악돼서 호평이 나왔다"고 정리했습니다 (The Claudese Correction).
- 실무 분업 패턴도 자리 잡았습니다. Hacker News의 hombre_fatal은 "Fable로 계획을 세우고 Codex/Sol로 그 계획을 검토한다"고 했고, 커뮤니티에서는 "계획은 Fable, 구현은 Opus"라는 조합이 반복해서 언급됐습니다.
- Every의 Dan Shipper는 Sol과 Opus 5.5를 같은 업무로 직접 비교하며, 글쓰기는 Sol이 Astra에 가깝고("군더더기 없이 핵심을 먼저 쓴다"), 컴퓨터 사용도 Sol이 좋지만 길고 자율적인 코딩 작업에서는 Opus 5.5의 상한이 더 높다고 평가했습니다 (X 게시물).
- 단점도 분명했습니다. Simon Willison은 자기 표준 테스트(자전거 타는 펠리컨 SVG)에서 Opus 5.5가 max 추론으로 응답을 아예 반환하지 못했다고 기록했습니다. 너무 오래 생각하다 실패한 사례입니다 (Simon Willison).
공통적으로 반복된 세 가지 평가
- 이번 라운드의 진짜 뉴스는 성능보다 가격이라는 반응이 많았습니다.
- 사용량 한도 체감이 모델 선택만큼 중요해졌습니다. 구독제로 쓰는 사람에게는 토큰 단가보다 "며칠 버티는가"가 실제 기준입니다.
- 추론 강도(effort) 설정이 모델 선택만큼 결과를 바꿉니다. 특히 Opus 5.5는 max보다 medium에서 비용 대비 효율이 좋다는 평가가 반복됐습니다.
6. 실제 작업에서는 어떤 차이가 있는가
글쓰기 — GPT-6 계열은 문장이 더 간결해졌고, Opus 5.5는 장황함을 줄이면서 앞에 결론을 두는 방향으로 바뀌었습니다. 다만 Opus 5.5는 여전히 초안에서 논점을 뒤로 미루는 경향이 있다는 관측(Dan Shipper)과, 그 반대로 "내가 쓰는 방식대로 쓴다"는 초기 테스터 평가(Anthropic)가 함께 있습니다. 어느 쪽이든 취향과 프롬프트에 따라 갈리는 영역입니다.
코딩 — 독립 지표 기준으로 Opus 5.5가 여러 코딩·에이전트 평가에서 앞섭니다. 다만 r/codex 사례들처럼 범위를 넘어서는 수정이 나올 수 있어서, 작은 단위로 지시하고 커밋을 자주 남기는 운용이 필요합니다. Sol은 과제당 비용이 낮아 반복 실험이 잦은 작업에 유리합니다.
리서치 — 장문 이해도(AA-LCR)는 세 모델이 83~85%로 거의 같은 수준입니다. 차이는 속도와 비용에서 갈립니다. 대량 문서를 훑는 작업은 Luna, 판단이 필요한 정리는 Sol이나 Opus 5.5가 어울립니다.
에이전트 — Terminal-Bench 4.0에서 격차가 가장 크게 벌어졌습니다(Opus 5.5 60%, Sol 44%, Luna 13%). 오래 혼자 돌아가야 하는 작업일수록 이 차이가 체감됩니다.
일상적인 질문 — Luna의 속도(167 t/s)와 가격은 이 영역에서 압도적입니다. 다만 사실성 지표(AA-Omniscience)가 1로 매우 낮아서, 사실 확인이 중요한 질문에는 부적합합니다. 이 지표는 정답을 맞히면 가점, 환각이면 감점하는 방식이라 낮은 점수는 그만큼 틀린 답이 많다는 뜻입니다.
7. 각 모델의 강점과 약점
GPT-6 Sol
- 강점: 단가 대비 성능 균형, 빠른 응답 시작, 낮은 과제당 비용, 넓은 컨텍스트
- 약점: Terminal-Bench·SciCode 등에서 Opus 5.5에 뒤짐, 지시 범위를 넘는 과잉 수정 사례 보고, 구독 사용량 소진이 빠르다는 불만
GPT-6 Luna
- 강점: 가장 낮은 단가와 가장 빠른 출력, 캐시 단가가 특히 저렴, 큰 컨텍스트
- 약점: 사실성·복잡한 에이전트 작업에서 뚜렷하게 약함, Terminal-Bench 4.0 13%, 남이 검증해줘야 하는 모델이라는 평가
Claude Opus 5.5
- 강점: 독립 평가 종합 1위, 사실성 지표 최상위, 긴 자율 작업에서 상한이 높음, 캐시 읽기 단가 대폭 인하
- 약점: 토큰을 많이 써서 과제당 실제 비용이 가장 높음, 추론 강도 높이면 첫 응답까지 오래 걸림, 사이버보안·생물 관련 요청이 구형 모델로 우회될 수 있음, 이미지 출력 미지원
8. 어떤 사용자에게 어떤 특성이 맞는지
- 비용이 최우선이고 결과를 직접 검증할 수 있다 → GPT-6 Luna
- 반복 실험이 많고 응답 속도가 중요하다 → GPT-6 Sol
- 어렵고 긴 작업을 끝까지 맡기고 싶다 → Claude Opus 5.5 (단, 기본 추론 강도에서 시작해 필요한 만큼만 올리는 운용이 유리)
- 한 회사에 묶이기 싫다 → 계획·검토와 구현을 다른 모델로 나누는 조합. 실제로 커뮤니티에서 가장 많이 언급된 방식입니다.
9. 결론 — 숫자만으로는 모델을 고를 수 없는 이유
이번 세 모델을 보면 세 가지가 분명해집니다.
첫째, 벤치마크 숫자는 이제 실사용 차이를 설명하는 힘이 약해졌습니다. Anthropic 스스로 "이 수준의 성능에서는 벤치마크 격차가 실제 차이를 반영하기 어렵다"고 발표문에 적었습니다. 같은 Terminal-Bench 4.0에서도 66.4%, 63.1%, 59.6%라는 서로 다른 숫자가 조건에 따라 나옵니다.
둘째, 단가와 청구액은 다른 문제입니다. Opus 5.5는 토큰 단가를 20% 내리고 캐시 읽기를 60% 깎았는데도, 토큰을 더 많이 쓰기 때문에 과제당 비용은 올랐습니다. 반대로 Luna는 단가가 가장 싸지만 토큰을 더 쓰는 경향이 있습니다.
셋째, 추론 강도 설정이 모델 선택만큼 중요합니다. 같은 모델이라도 effort를 어디에 두느냐에 따라 비용과 결과가 크게 달라집니다.
그래서 결론은 이렇습니다. 어느 모델이 "무조건 좋다"가 아니라, 내 작업에서 어떤 지점이 병목인지(비용인지, 정확성인지, 자율 실행 시간인지)를 먼저 정하고 그에 맞춰 고르는 게 맞습니다. 실제로 커뮤니티에서 가장 만족도가 높았던 방식은 한 모델로 전부 해결하는 것이 아니라, 계획·구현·검토를 역할별로 나눠 조합하는 패턴이었습니다.
안내: 이 글은 공개된 공식 문서와 독립 평가, 공개 커뮤니티 논의를 정리한 정보성 글입니다. 특정 서비스의 구매나 사용을 권하는 내용이 아니며, 가격과 성능은 발표 시점 기준으로 이후 변경될 수 있습니다.